
[论文解读] Open-Vocabulary Panoptic Segmentation with Text-to-Image Diffusion Models
ODISE 利用冻结的文本到图像扩散模型表示和判别模型来执行开放词汇全景分割,在开放词汇全景和语义分割基准上达到最先进的结果。
We present ODISE: Open-vocabulary DIffusion-based panoptic SEgmentation, which unifies pre-trained text-image diffusion and discriminative models to perform open-vocabulary panoptic segmentation. Text-to-image diffusion models have the remarkable ability to generate high-quality images with diverse open-vocabulary language descriptions. This demonstrates that their internal representation space is highly correlated with open concepts in the real world. Text-image discriminative models like CLIP, on the other hand, are good at classifying images into open-vocabulary labels. We leverage the frozen internal representations of both these models to perform panoptic segmentation of any category in the wild. Our approach outperforms the previous state of the art by significant margins on both open-vocabulary panoptic and semantic segmentation tasks. In particular, with COCO training only, our method achieves 23.4 PQ and 30.0 mIoU on the ADE20K dataset, with 8.3 PQ and 7.9 mIoU absolute improvement over the previous state of the art. We open-source our code and models at https://github.com/NVlabs/ODISE .
研究动机与目标
- 通过利用扩散模型表示,将开放词汇识别与全景分割桥接。
- 将预训练的文本到图像扩散特征与判别模型统一用于开放类别标注。
- 使用类别标签或图像标题来训练掩码生成器和开放词汇分类器。
- 展示在开放词汇全景分割与语义分割基准上的最新性能。
提出的方法
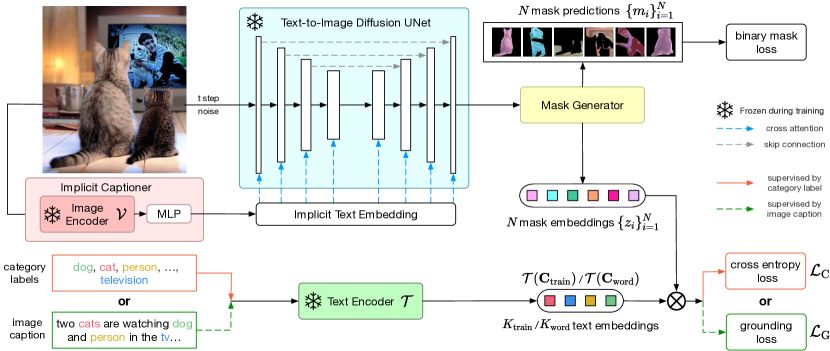
- 从冻结的文本到图像扩散UNet提取扩散模型特征,使用隐式字幕器来生成图像条件特征图。
- 训练掩码生成器,从扩散特征预测类别无关的二值掩码及相应的掩码嵌入。
- 通过计算掩码嵌入与训练类别名称的文本嵌入或来自图像标题的名词的文本嵌入之间的相似度来对每个掩码进行分类,使用交叉熵或对齐损失。
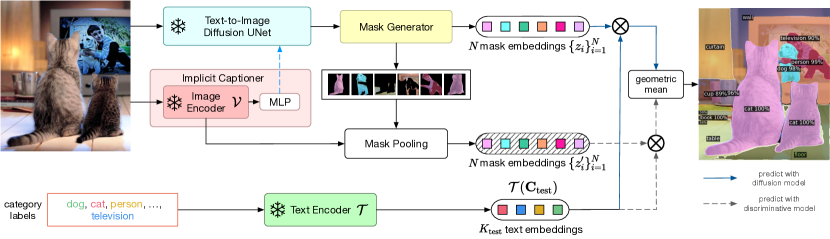
- 推理阶段,使用 ODISE 生成掩码,并通过几何均值将扩散模型的预测与判别模型(CLIP)的预测融合,以获得最终的开放词汇标签。
实验结果
研究问题
- RQ1是否可以通过利用大规模文本到图像扩散模型的内部表示来有效学习开放词汇全景分割?
- RQ2将基于扩散的特征与判别性文本-图像模型结合,是否能获得更优的开放词汇分割性能?
- RQ3当测试时无法获取标题时,应该如何构建隐式字幕以最大化扩散模型特征质量?
- RQ4开放词汇分割中字幕监督与无字幕方法之间有哪些权衡?
主要发现
- ODISE 在开放词汇全景分割上达到最新结果,特别是在 ADE20K 上的 PQ 23.4,mIoU 28.7–29.9,在 COCO 上 55.4 PQ / 65.2 mIoU,且在不同监督设置下。
- 使用标签+掩码监督在上述设置下 ADE20K 的 PQ(22.6)和 mIoU(29.9)高于字幕监督(23.4 PQ, 28.7 mIoU);COCO 结果仍然强劲(55.4 PQ, 65.2 mIoU)。
- ODISE 在 ADE20K 的开放词汇全景分割上比 MaskCLIP 高出 8.3 PQ。
- 开放词汇语义分割在 A-150、A-847、PC-459 数据集上,在字幕和标签监督下都显著受益,mIoU 提升多点。
- 一个紧凑模型(28.1M 可训练参数,占全模型的 1.8%,并有 1,493.8M 的冻结参数)在 V100 上对 1024^2 图像实现 1.26 FPS,内存 11.9 GB。
- 将扩散模型与判别模型预测融合(几何平均)在评估数据集上比单独使用任一方法获得更好的结果。
阅读本论文
在 Nubint 阅读器中打开原文,边读边就任意段落提问。
在 Nubint 中阅读本论文本解读由 AI 根据论文原文生成,引用前请核对原文。