
[論文レビュー] LLM in a flash: Efficient Large Language Model Inference with Limited Memory
本論文は LLM の重みをフラッシュメモリに格納し、windowing と row-column bundling というハードウェア認識技術を用いてオンデマンドで読み込みを実行する。これにより DRAM を超えるモデルで推論を可能にし、ナイーブな読み込みに比べて大幅な速度向上を達成する。
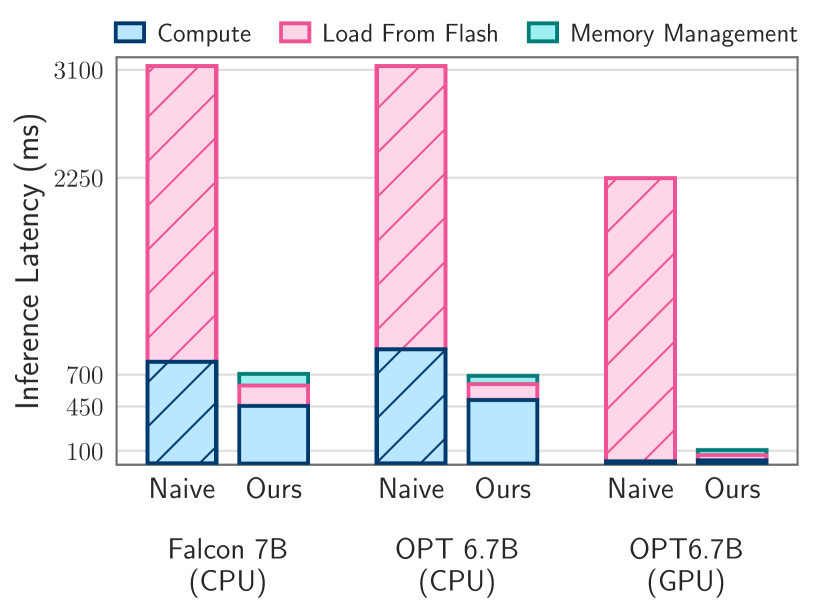
Large language models (LLMs) are central to modern natural language processing, delivering exceptional performance in various tasks. However, their substantial computational and memory requirements present challenges, especially for devices with limited DRAM capacity. This paper tackles the challenge of efficiently running LLMs that exceed the available DRAM capacity by storing the model parameters in flash memory, but bringing them on demand to DRAM. Our method involves constructing an inference cost model that takes into account the characteristics of flash memory, guiding us to optimize in two critical areas: reducing the volume of data transferred from flash and reading data in larger, more contiguous chunks. Within this hardware-informed framework, we introduce two principal techniques. First, "windowing" strategically reduces data transfer by reusing previously activated neurons, and second, "row-column bundling", tailored to the sequential data access strengths of flash memory, increases the size of data chunks read from flash memory. These methods collectively enable running models up to twice the size of the available DRAM, with a 4-5x and 20-25x increase in inference speed compared to naive loading approaches in CPU and GPU, respectively. Our integration of sparsity awareness, context-adaptive loading, and a hardware-oriented design paves the way for effective inference of LLMs on devices with limited memory.
研究の動機と目的
- 利用可能な DRAM を超える LLM の実行を促進するため、パラメータをフラッシュメモリに格納し、推論中にオンデマンドで読み込む。
- フラッシュと DRAM の特性を考慮したハードウェア情報に基づくコストモデルを開発し、データ転送を導く。
- データ転送を削減しフラッシュのスループットを向上させ、デバイス上でより大規模な推論を可能にする手法を提案する。
- スパース性とメモリ管理戦略が DRAM のフットプリントを大幅に削減し、推論を高速化できることを示す。
提案手法
- フラッシュメモリ、DRAM、および計算ハードウェアの特性を組み込んだ推論コストモデルを構築する。
- 過去のトークンに対して重みを再利用するウィンドウ処理を導入し IO 要求を削減する。
- 関連する行/列をペアにしてフラッシュからより大きな連続チャンクを読み取るための row-column bundling を導入する。
- FFN のスパース性と低秩予測子を利用して、非ゼロまたは活性化する可能性の高い重みのみを読み込む。
- 静的 DRAM 前割り当てとスライディングウィンドウ ニューロンデータ管理方式を実装し、メモリ再割り当てを最小化する。
- CPU(DRAM+フラッシュ)と GPU 設定で OPT 6.7B および sparsified Falcon 7B を用いて評価し、フルロードのベースラインと比較する。
実験結果
リサーチクエスチョン
- RQ1フラッシュメモリからのオンデマンド読み込みは、利用可能な DRAM を超えるモデルの LLM 推論をサポートできるか?
- RQ2ハードウェア認識のデータ転送戦略(windowing と bundling)が、フラッシュに居る重みの待ち時間とスループットにどのように影響するか?
- RQ3ゼロショットタスクで精度を損なうことなく、スパース性予測がデータ転送をどの程度削減できるか?
- RQ4限られた DRAM を持つエッジ型ハードウェアで 7B–6.7B スケールのモデルを実行する場合の実用的な待ち時間とメモリフットプリントのトレードオフは?
- RQ5同様のメモリ制約下で、これらのアプローチは既存のベースライン/フレックスオフロード戦略(例: FlexGen)とどのように比較されるか?
主な発見
- 利用可能 DRAM の約2倍のサイズのモデルを、フラッシュからオンデマンドで重みを読み込むことで実行できる。
- CPU 構成ではナイーブな読み込みに対する4–5xの速度向上;GPU 構成では20–25xの速度向上。
- Windowing により新規データ読み込みをFFNニューロンのおよそ2.4%(5トークンのウィンドウ)程度に削減し、DRAM帯域を節約。
- Row-column bundling は読み取りチャンクサイズを倍増させ、より大きな連続ブロックを読むことでフラッシュのスループットを改善。
- 低秩予測子とスパース性対応の読み込みにより、ゼロショットタスクの精度を保ちながらデータ転送を大幅に削減。
- フルリロードベースラインと比較して、提案手法は I/O 遅延を劇的に削減(例:特定の構成で1トークンあたり約2330 msから約87 msまで低下)。

この論文を読む
Nubintのビューアで原文を開き、読みながら気になる箇所をすぐに質問できます。
Nubintでこの論文を読むこのレビューはAIが論文の原文をもとに作成しました。引用する前に原文をご確認ください。