
[論文レビュー] Nightshade: Prompt-Specific Poisoning Attacks on Text-to-Image Generative Models
この論文は、テキストから画像への拡散モデルがプロンプト特異的なデータ汚染に脆弱であることを示し、Nightshadeを導入する。Nightshadeはステルス性が高く最適化されたポイズニング手法で、比較的少数のサンプルで有効かつ関連するプロンプトへと情報が漏れ出す可能性がある。
Data poisoning attacks manipulate training data to introduce unexpected behaviors into machine learning models at training time. For text-to-image generative models with massive training datasets, current understanding of poisoning attacks suggests that a successful attack would require injecting millions of poison samples into their training pipeline. In this paper, we show that poisoning attacks can be successful on generative models. We observe that training data per concept can be quite limited in these models, making them vulnerable to prompt-specific poisoning attacks, which target a model's ability to respond to individual prompts. We introduce Nightshade, an optimized prompt-specific poisoning attack where poison samples look visually identical to benign images with matching text prompts. Nightshade poison samples are also optimized for potency and can corrupt an Stable Diffusion SDXL prompt in <100 poison samples. Nightshade poison effects "bleed through" to related concepts, and multiple attacks can composed together in a single prompt. Surprisingly, we show that a moderate number of Nightshade attacks can destabilize general features in a text-to-image generative model, effectively disabling its ability to generate meaningful images. Finally, we propose the use of Nightshade and similar tools as a last defense for content creators against web scrapers that ignore opt-out/do-not-crawl directives, and discuss possible implications for model trainers and content creators.
研究の動機と目的
- 拡散モデルベースのテキストから画像への変換が、特定のプロンプトを対象としたデータ汚染攻撃に脆弱であることを示す。
- 低いトレーニングデータ密度(概念のまばらさ)が、効果的なプロンプト特異的データ汚染を可能にすることを示す。
- Nightshadeを開発し、少数のサンプルでなおかつステルス性を保ちつつ高い効果を発揮する最適化されたポイズニング手法を構築する。
- 関連概念への情報漏れ(ブリードスルー)効果と、モデル間の転移性を検討する。
- コンテンツ制作者の著作権保護ツールとしての正当な利用可能性を議論する。
提案手法
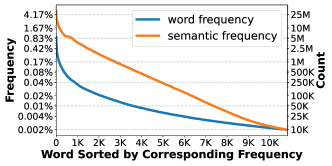
- 大規模拡散データセットにおける概念のまばらさを分析し、概念の語彙頻度と意味頻度を定量化する。
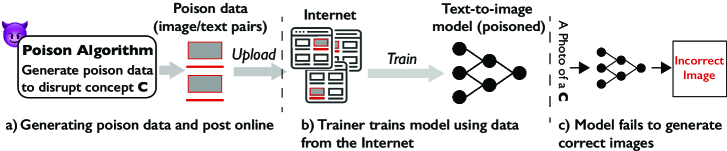
- 比較的少量のポイズニングデータ(例:500–1000サンプル)で基準となる効果を確立するため、単純なダーティラベル汚染攻撃を評価する。
- 対象概念を明確に伝えるテキストプロンプトと、無関係な目的地概念の画像を組み合わせ、次にクリーンラベル汚染手法で画像を自然に見せるよう摂動を加えてNightshadeを開発する。
- 目的概念のアンカー画像を生成し、拘束的な摂動を適用して、損害ポイズニング画像を特徴空間でターゲット概念に整合させる(LPIPS予算)。
- 勾配に類似した直感を用いて、検出を避けるために視覚的整合性を保ちながら、対象概念に関連するモデルの訓練へのポイズンデータの影響を最大化する。
実験結果
リサーチクエスチョン
- RQ1トレーニングパイプラインへのアクセスなしに、拡散ベースのテキスト-to-画像モデルでプロンプト特異的汚染攻撃は成功するか。
- RQ2トレーニングデータの概念まばらさは、汚染攻撃の実行可能性と強さにどう影響するか?
- RQ3Nightshadeアプローチは、検出を避けつつ必要な汚染サンプル数を減らす上でどれほど効果的か?
- RQ4Nightshade攻撃は意味的に関連するプロンプトへのブリードスルーや、複数のターゲットにわたる累積効果を示すか?
- RQ5Nightshade攻撃の異なるモデル間での転移性および防御耐性はどの程度か?
主な発見
- プロンプト特異的なデータ汚染攻撃は、概念のまばらさを活用して、比較的少数の汚染サンプルで高い成功を収めることができる。
- 単純なダーティラベル汚染攻撃は、いくつかの設定で500–1000サンプルでターゲット概念を混乱させることができる。
- Nightshadeはさらに効果を高め、特定の場合には約100サンプル程度で有効な汚染を達成する。
- Nightshade汚染の効果は関連概念にブリードスルーし、同じプロンプトで複数の概念が汚染されると積み重なることがある。
- 汚染攻撃はモデル間で転移性を示し、いくつかの防御に対して耐性を示すが、多数のプロンプトに及ぶ広範な汚染はモデルの一般的特徴を不安定化させる可能性がある。
この論文を読む
Nubintのビューアで原文を開き、読みながら気になる箇所をすぐに質問できます。
Nubintでこの論文を読むこのレビューはAIが論文の原文をもとに作成しました。引用する前に原文をご確認ください。