
[論文レビュー] TD-MPC2: Scalable, Robust World Models for Continuous Control
TD-MPC2は単一のハイパーパラメータセットで104タスクを通じて強力なパフォーマンスを発揮する堅牢でスケーラブルなworld modelを提供。世界モデルを最大317Mパラメータまで拡張してマルチタスク学習を可能にする。
TD-MPC is a model-based reinforcement learning (RL) algorithm that performs local trajectory optimization in the latent space of a learned implicit (decoder-free) world model. In this work, we present TD-MPC2: a series of improvements upon the TD-MPC algorithm. We demonstrate that TD-MPC2 improves significantly over baselines across 104 online RL tasks spanning 4 diverse task domains, achieving consistently strong results with a single set of hyperparameters. We further show that agent capabilities increase with model and data size, and successfully train a single 317M parameter agent to perform 80 tasks across multiple task domains, embodiments, and action spaces. We conclude with an account of lessons, opportunities, and risks associated with large TD-MPC2 agents. Explore videos, models, data, code, and more at https://tdmpc2.com
研究の動機と目的
- 大規模で未整備のマルチタスクデータセットを活用できる頑健な汎用的なモデルベース強化学習を動機づける。
- 多様な embodiment とアクション空間に対してタスク特定の調整を必要とせず動作するスケーラブルなworld-modelアーキテクチャを開発する。
- 大規模なモデルとデータセットがマルチタスク設定で徐々に能力を向上させることを実証する。
- より広い採用と再現性を促進するために、モデル、データ、コードといったオープンリソースを提供する。
提案手法
- アクション列を条件とした結果を予測する、デコーダを使わない暗黙のworld modelを学習する。
- 観測をデコードせずにworld modelを訓練するため、ジョイントエンベディング予測、報酬予測、およびTD学習を用いる。
- 訓練を安定化させるため、報酬と価値のターゲットを対数変換空間で離散回帰(クロスエントロピー)形式で扱う。
- Q関数のアンサンブルを訓練し、TDターゲットのバイアスを減らすためにEMAターゲットを用いる。
- Model Predictive Controlを用いたMPPIとポリシー事前分布を組み合わせて探索を導き、学習済みの終端値でブートストラップする。
- マルチタスク設定では、すべてのコンポーネントを制御するための固定次元の正規化されたタスクエンベディングを学習し、可変の観測/行動空間を扱うためにアクションマスキングを使用する。
実験結果
リサーチクエスチョン
- RQ1TD-MPC2はデータ効率の高い連続制御タスクにおいて最先端のモデルフリーおよびモデルベース手法とどのように比較されるか。
- RQ2TD-MPC2のアルゴリズム的イノベーションは単一のハイパーパラメータセットを使用して広範なタスクで頑健な性能を提供できるか。
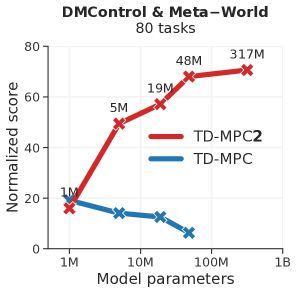
- RQ3より大きなモデルとより多くのデータは massively multitask TD-MPC2エージェントの能力を向上させるか、単一のエージェントで多くのドメインのタスクを実行できるか。
- RQ4設計選択(正規化、回帰目的、Q関数の個数)と計画の重要性は性能にどのような影響を与えるか。
- RQ5学習済みタスクエンベディングは意味論的に意味があるか、そして大規模マルチタスクエージェントは未見タスクに適応できるか。
主な発見
- TD-MPC2は単一のハイパーパラメータセットを用いて104タスクで強力なベースライン(SAC、DreamerV3、オリジナルTD-MPC)を上回る。
- モデルとデータサイズの拡大とともにエージェントの能力が向上し、317Mパラメータのworld modelでドメイン横断で80タスクを達成。
- マルチタスクTD-MPC2モデルはタスクエンベディングがダイナミクス/オブジェクトの相互作用でクラスタ化され、より大きいモデルは Saturationの明確な兆候なしに性能を向上させ続ける。
- TD-MPC2は従来の手法が発散した難易度の高いタスクにおいても安定性を維持し、計画が性能に大きく寄与する。
- 訓練コストはモデルサイズとともに増大し、例として317Mパラメータモデルは約33 GPU日で訓練され、80タスクデータセットで正規化スコア約70.6を達成。
- TD-MPC2はホールドアウトタスクに対してファイントuningを可能にし、低データレジームでスクラッチからの約2倍の改善を示す。

この論文を読む
Nubintのビューアで原文を開き、読みながら気になる箇所をすぐに質問できます。
Nubintでこの論文を読むこのレビューはAIが論文の原文をもとに作成しました。引用する前に原文をご確認ください。