
[논문 리뷰] Eliciting Latent Predictions from Transformers with the Tuned Lens
본 논문은 Tuned Lens를 소개합니다. 이는 affine-layer translator-based probe로, 중간 트랜스포머 은닉 상태를 최종 레이어 어휘 분포로 해독하여 logit lens보다 해석성을 향상시키고 인과 분석 및 이상 탐지를 가능하게 합니다.
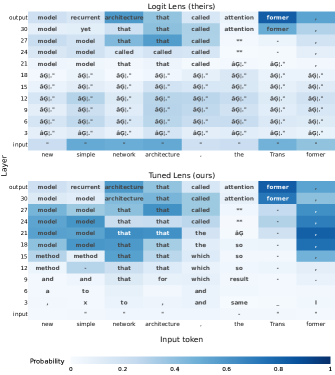
We analyze transformers from the perspective of iterative inference, seeking to understand how model predictions are refined layer by layer. To do so, we train an affine probe for each block in a frozen pretrained model, making it possible to decode every hidden state into a distribution over the vocabulary. Our method, the tuned lens, is a refinement of the earlier "logit lens" technique, which yielded useful insights but is often brittle. We test our method on various autoregressive language models with up to 20B parameters, showing it to be more predictive, reliable and unbiased than the logit lens. With causal experiments, we show the tuned lens uses similar features to the model itself. We also find the trajectory of latent predictions can be used to detect malicious inputs with high accuracy. All code needed to reproduce our results can be found at https://github.com/AlignmentResearch/tuned-lens.
연구 동기 및 목표
- 트랜스포머 예측이 반복 추론을 통해 계층별로 어떻게 정제되는지 조사한다.
- 다양한 사전학습 모델에서 동작하는 강건한 잠재 예측 디코딩 방법을 개발한다.
- 편향, perplexity, 해석가능성 측면에서 Tuned Lens와 Logit Lens를 비교한다.
- 프로브의 인과 충실성을 입증하고 악의적 입력 및 모델 변경 탐지에 유용함을 보여준다.
제안 방법
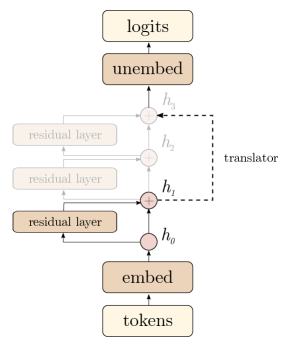
- 각 계층에 대해 hidden states를 최종 계층 unembedding 공간으로 매핑하는 affine translator를 학습한다.
- 각 계층의 번역된 예측을 최종 계층 로짓과 맞추기 위해 증류와 유사한 KL 손실을 사용하여 각 계층의 번역된 예측을 최종 계층 로짓과 정렬시키다.
- 로짓 렌즈 출력의 편향을 제거하기 위해 제로 잔차 가정을 학습 가능한 바이어스로 대체한다.
- 최대 20B 파라미터에 이르는 여러 자기회귀 모델에 대해 평가하고 예측 추이를 분석한다.
- 출력에 영향을 주는 잔류 스트림의 방향을 식별하기 위한 causal basis extraction (CBE)을 개발한다.
- 조정된 렌즈 개입과 모델 출력 사이의 자극-반응 정렬을 측정하기 위해 Aitchison 기하를 적용한다.
실험 결과
연구 질문
- RQ1다양한 모델에 걸쳐 Tuned Lens가 Logit Lens보다 더 정확하고 안정적인 잠재 예측을 생성합니까?
- RQ2Tuned Lens가 선택한 특징이 모델의 최종 출력과 인과적으로 정렬되어 있습니까?
- RQ3Tuned Lens 예측 추이가 이상한 입력이나 프롬프트 주입을 드러낼 수 있습니까?
- RQ4계층, 모델 및 파인튜닝된 변형 간에 Tuned Lens의 전달은 얼마나 잘 이루어지나요?
- RQ5Tuned Lens에 영향력을 주는 잠재 방향과 실제 모델 출력에 영향을 주는 방향 사이의 관계는 무엇입니까?
주요 결과
- Tuned Lens 예측은 BLOOM, GPT-NeoX-20B, Pythia와 같은 모델에서 Logit Lens 예측에 비해 퍼플렉시티가 크게 낮고 편향이 적습니다.
- 하나의 계층에서 학습된 렌즈는 인접 계층으로 전달되며 전송 페널티가 낮고, 파인튜닝된 모델로의 전달도 저하가 최소화됩니다.
- Causal basis extraction은 잔류 스트림에서 Tuned Lens와 모델 출력 모두에 인과적으로 영향을 주는 방향을 드러내고 있으며(높은 자극-반응 정렬).
- Tuned Lens를 이용한 예측 추적은 여러 작업에서 프롬프트 주입 공격을 거의 완벽에 가까운 AUROC로 탐지할 수 있습니다.
- Tuned Lens는 파인튜닝 중 표현의 모니터링과 비교를 가능하게 하며, 새로운 모델에서 프로브를 재학습할 필요가 거의 없습니다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.