
[논문 리뷰] EmerNeRF: Emergent Spatial-Temporal Scene Decomposition via Self-Supervision
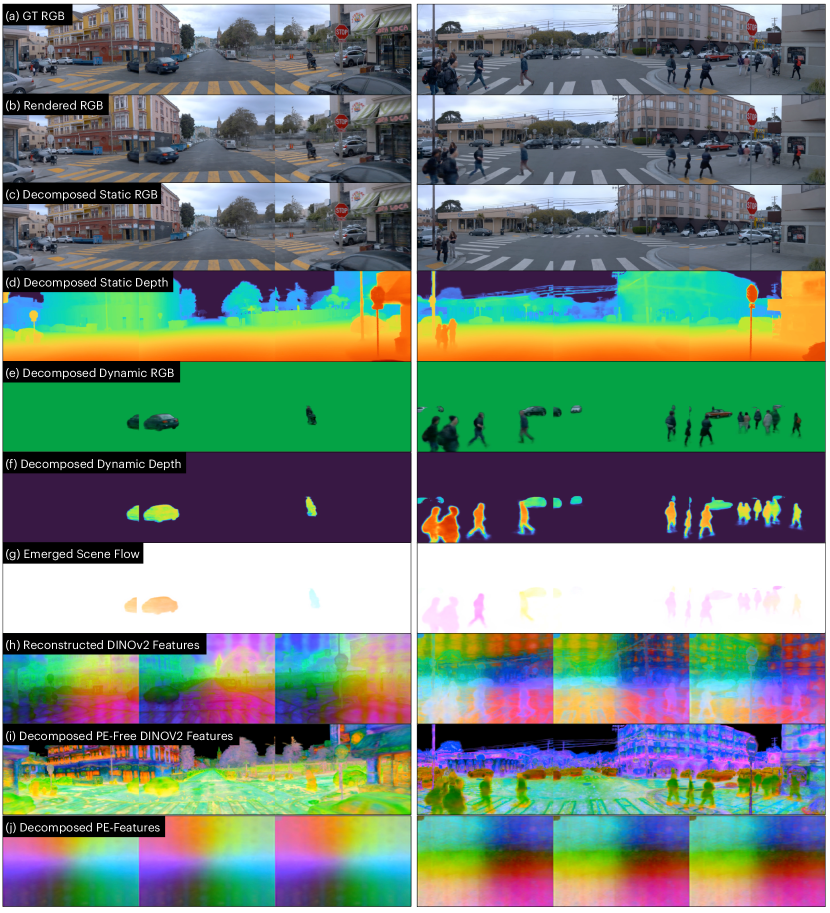
EmerNeRF는 자기지도(self-supervision)에서 4D 정적/동적 장면 표현을 학습하고, 장면 흐름(scene flow)을 등장시키며, 2D 기초모델 피처를 4D 시공간으로 올린다. ground-truth 분할 없이 또는 사전 학습된 흐름 모델 없이도 NOTR에서 정적/동적 장면 재구성, 새로운 시점 렌더링(novel view synthesis), 장면 흐름 추정에서 최첨단 성능을 달성한다.
We present EmerNeRF, a simple yet powerful approach for learning spatial-temporal representations of dynamic driving scenes. Grounded in neural fields, EmerNeRF simultaneously captures scene geometry, appearance, motion, and semantics via self-bootstrapping. EmerNeRF hinges upon two core components: First, it stratifies scenes into static and dynamic fields. This decomposition emerges purely from self-supervision, enabling our model to learn from general, in-the-wild data sources. Second, EmerNeRF parameterizes an induced flow field from the dynamic field and uses this flow field to further aggregate multi-frame features, amplifying the rendering precision of dynamic objects. Coupling these three fields (static, dynamic, and flow) enables EmerNeRF to represent highly-dynamic scenes self-sufficiently, without relying on ground truth object annotations or pre-trained models for dynamic object segmentation or optical flow estimation. Our method achieves state-of-the-art performance in sensor simulation, significantly outperforming previous methods when reconstructing static (+2.93 PSNR) and dynamic (+3.70 PSNR) scenes. In addition, to bolster EmerNeRF's semantic generalization, we lift 2D visual foundation model features into 4D space-time and address a general positional bias in modern Transformers, significantly boosting 3D perception performance (e.g., 37.50% relative improvement in occupancy prediction accuracy on average). Finally, we construct a diverse and challenging 120-sequence dataset to benchmark neural fields under extreme and highly-dynamic settings.
연구 동기 및 목표
- 수동 주석 없이 동적 주행 장면의 정적 구성 요소와 동적 구성 요소를 분리한다.
- 시간적으로 배치된 특징을 집계하기 위한 emergent scene flow를 학습하여 동적 물체 표현을 향상시킨다.
- 위치 임베딩 아티팩트를 완화하면서 2D 기초 모델 피처를 4D 시공간으로 올려 도메인 이해를 향상시킨다.
- 다양한 운전 데이터셋에서 4D 신경장 재구성을 벤치마크하고 NOTR을 균형 잡힌 도로 주행 벤치마크로 확립한다.
제안 방법
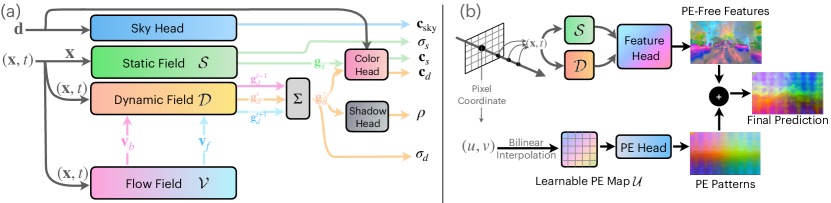
- 정적(x) 및 동적(x, t) 필드로 학습 가능한 해시 격자를 사용해 장면을 분해한다.
- 공유 색상 헤드에서 포인트별 색상을 예측하고 하늘 및 그림자 구성요소를 별도로 예측한다.
- 재구성 손실만으로 학습되는 emergent 3D 장면 흐름 필드(v_f, v_b)를 도입하여 인접 프레임 피처를 시계열로 집계하는 데 사용한다.
- 전방/후방 흐름을 통해 시간에 걸쳐 동적 피처를 집계하여 동적 객체 렌더링 향상을 위한 g_d'를 생성한다.
- 2D 기초 모델 피처(예: DINOv1/v2)를 4D 공간으로 올리고, 트랜스포머 위치 임베딩 패턴을 완화하기 위한 학습 가능한 PE 제거 모듈을 둔다.
- 밀도 규제 손실을 사용해 필요할 때만 동적 밀도를 촉진하고 흐름 필드에 대해 순환 일관성 손실을 사용한다.
- 최적화는 rgb, sky, shadow, depth 및 선택적 피처 손실과 PE 인식 피처 재구성을 결합한다.
실험 결과
연구 질문
- RQ1자기지도 프레임워크가 4D 주행 장면을 정적 및 동적 구성 요소로 분리할 수 있는가? ground-truth 주석 없이.
- RQ2 emergent scene flow가 NeRF 기반 표현에서 동적 물체를 위한 다중 프레임 피처의 효과적인 집계를 가능하게 하는가?
- RQ34D 공간으로 올려진 2D 기초 모델 피처가 시맨틱 인식 작업을 향상시키며, 트랜스포머의 PE 패턴을 완화해 3D 일관성을 높일 수 있는가?
- RQ4기존의 NeRF 기반 방법들과 비교했을 때 정적/동적 재구성, 새로운 시점 합성(novel view synthesis), 장면 흐름 추정에서 EmerNeRF의 성능은 어떠한가?
주요 결과
- EmerNeRF는 NOTR에서 최첨단 재구성 및 새로운 시점 합성을 달성하며, 정적(+2.93) 및 동적(+3.70) 장면에서 기존 NeRF 기반 방법들을 크게 능가하는 PSNR 이득을 보이고, 동적 시점의 PSNR 이득은 +2.91이다.
- 장면 흐름 추정은 NSFP 대비 현저하게 향상되며, EPE3D가 0.365 m에서 0.014 m로 감소하고 Acc_5/Acc_10이 더 높아진다.
- ViT 모델에서 PE-free 4D 피처를 올리면 큰 의미-점유 증가를 얻고, PE 패턴 제거는 3D 인식 과제에서 최대 63.22% 상대 마이크로 정확도 향상과 37.50% 평균 향상을 달성한다.
- PE 분해는 특히 DINOv2에서 특징 합성 품질의 큰 이점을 가능하게 하며, 정적/동적/다양한 분할 전반에서 주목할 만한 PSNR/점유 개선이 있다.
- NOTR은 도전적인 조건(황혼/새벽, 비, 야간)에서 정적/동적 NeRF를 평가하기 위한 균형 잡히고 다양한 벤치마크(120 시퀀스)를 제공한다.
- Emergent 흐름은 재구성 손실에 의해 주도되는 시간적 특징 집계에서 비롯되며 광학 흐름의 명시적 감독 없이 발생한다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.