
[논문 리뷰] Fast Training of Diffusion Models with Masked Transformers
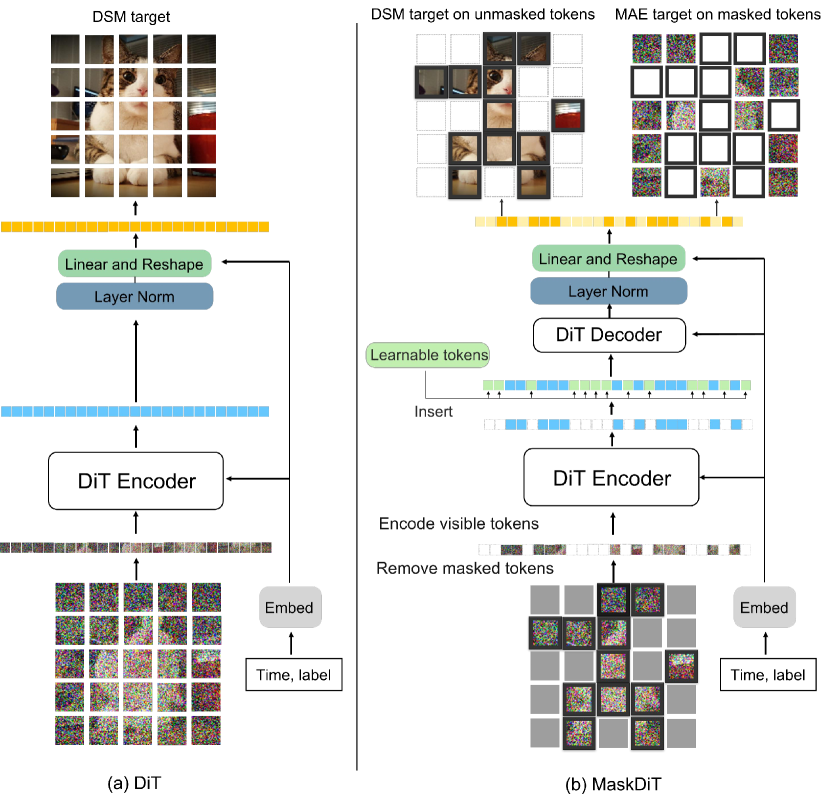
MaskDiT는 입력 패치의 50%를 마스킹하고 비대칭 인코더–디코더를 사용하며 비마스킹 패치에 DSM을 적용하고 마스킹 패치에 대해 MAE 스타일 재구성을 수행함으로써 확산 모델의 학습을 더 효율적으로 수행한다; 또한 DiT의 학습 시간의 약 31% 수준으로 경쟁력 있는 FID를 달성한다.
We propose an efficient approach to train large diffusion models with masked transformers. While masked transformers have been extensively explored for representation learning, their application to generative learning is less explored in the vision domain. Our work is the first to exploit masked training to reduce the training cost of diffusion models significantly. Specifically, we randomly mask out a high proportion (e.g., 50%) of patches in diffused input images during training. For masked training, we introduce an asymmetric encoder-decoder architecture consisting of a transformer encoder that operates only on unmasked patches and a lightweight transformer decoder on full patches. To promote a long-range understanding of full patches, we add an auxiliary task of reconstructing masked patches to the denoising score matching objective that learns the score of unmasked patches. Experiments on ImageNet-256x256 and ImageNet-512x512 show that our approach achieves competitive and even better generative performance than the state-of-the-art Diffusion Transformer (DiT) model, using only around 30% of its original training time. Thus, our method shows a promising way of efficiently training large transformer-based diffusion models without sacrificing the generative performance.
연구 동기 및 목표
- 대규모 확산 모델의 학습 비용을 희생 없이 감소시키는 것을 목표로 한다.
- 확산 모델의 각 반복 계산량과 메모리를 줄이기 위해 마스크된 트랜스포머 학습을 활용한다.
- 비대칭 인코더–디코더 백본과 마스크 입력을 다루기 위한 이중 목표를 제안한다.
- 대상 데이터(ImageNet-256×256)에서 강력한 생성 성능을 달성하면서도 상당한 학습 시간 절감을 입증한다.
제안 방법
- 인코더가 비마스크 패치에서 작동하고 경량 디코더가 전체 토큰을 처리하는 비대칭 인코더–디코더 트랜스포머 백본을 채택한다.
- 확산 모델 학습 중 입력 패치의 높은 비율(50%)을 무작위로 마스킹하여 각 반복의 계산량을 줄인다.
- 비마스크 패치에서 denoising score matching(DSM)과 마스크된 패치에서 보조 MAE 스타일 재구성 손실을 병합하는 이중 학습 목표를 도입한다.
- 학습은 동일한 마스킹 비율을 타임스텝 전반에 걸쳐 사용하고 추후 학습-추론 간 격차를 줄이기 위한 최소한의 마스킹 해제 튜닝을 수행한다.
- 마스킹 학습 후 CFG 샘플링 성능을 향상시키기 위해 0 비율 또는 코사인 비율의 해제 튜닝 스케줄을 사용한다.
- FID 및 관련 지표를 사용하여 ImageNet-256×256에서 DiT 및 MDT 기준선과 비교하고 classifier-free 가이던스 여부를 고려한다.
실험 결과
연구 질문
- RQ1마스크된 트랜스포머 학습이 생성 성능을 희생하지 않으면서 확산 모델의 학습 비용을 줄일 수 있는가?
- RQ2마스크 입력을 다루기 위한 확산 모델의 아키텍처와 학습 목표를 어떻게 설계해야 하는가?
- RQ3마스킹 비율, 재구성 손실 가중치, 해제 튜닝 간의 트레이드오프가 모델 품질에 어떤 영향을 미치는가?
- RQ4MaskDiT가 ImageNet-256×256에서 최신 확산 모델과 비교해 효율성과 샘플 품질에서 어떤 차이를 보이는가?
- RQ5가이던스(CFG)와 해제 튜닝이 최종 생성 지표에 미치는 영향은 무엇인가?
주요 결과
- MaskDiT는 가이던스 없이도 ImageNet-256×256에서 5.69의 FID를 달성하며, 비계단식 확산 모델 중 다수보다 우수하고 가이던스가 있을 때는 최첨단에 근접한다.
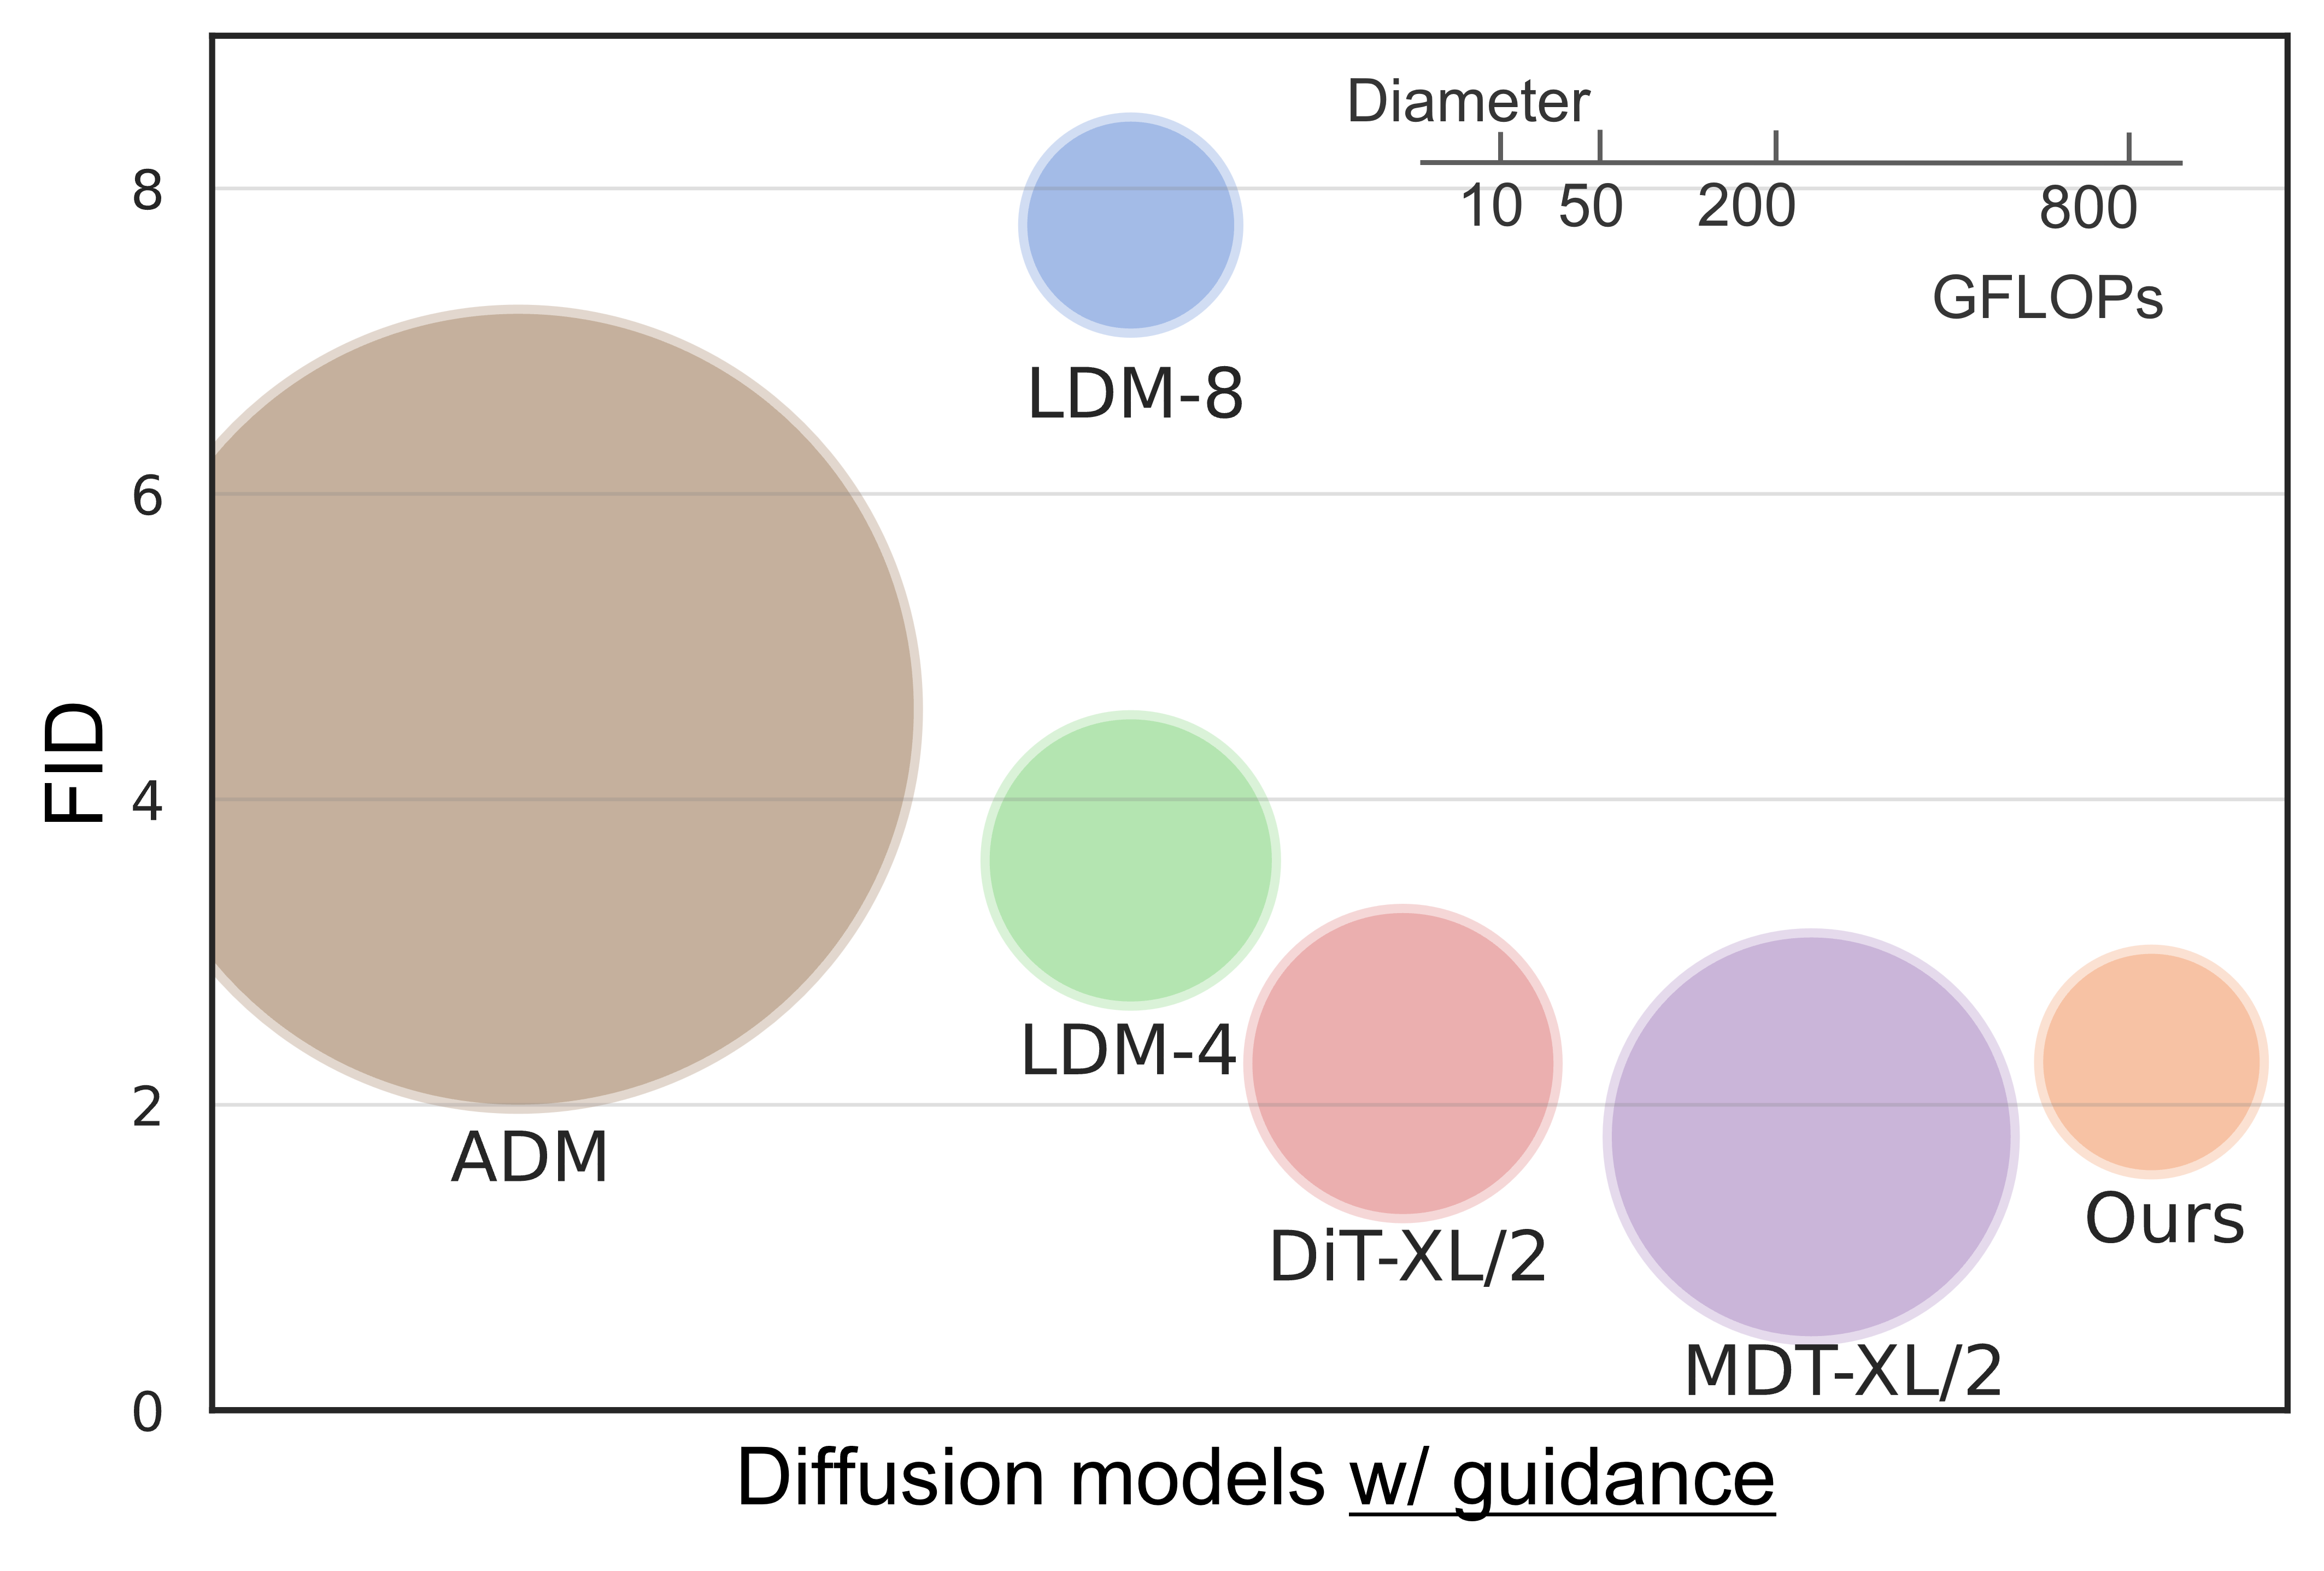
- 클래스 무료(guidance 없는) 가이던스에서 MaskDiT는 2.28의 FID를 달성하며 이는 DiT-XL/2-G의 2.27과 비슷하고 DiT-XL/2의 학습 시간의 약 31%만 필요로 한다.
- 학습 속도와 GPU당 메모리 사용량이 크게 줄어듦: MaskDiT는 Forward 패스당 DiT의 54.0%, MDT의 GFLOPs의 31.7%를 사용하고 대역폭이 큰 배치 크기(1024)에서 특히 더 빠르게 수렴한다.
- MaskDiT-G(가이드가 있는 경우)는 최상의 가이드 모델에 근접한 성능을 달성하면서도 MDT-XL/2-G에 비해 더 낮은 계산 비용을 보인다.
- MAE 재구성 손실(MAE 계수 약 0.1)이 DSM 손실과 결합될 때 생성 품질과 안정성을 향상시킨다.
- 해제 튜닝은 CFG 성능을 추가로 개선하며 튜닝 단계가 증가할수록 최적의 가이드 스케일이 더 상승한다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.