
[논문 리뷰] LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning
LIBERO는 로봇 조작에서의 평생 학습을 위한 확장 가능하고 절차적으로 생성된 벤치마크를 도입하며, 지식 이전, 아키텍처, 알고리즘 및 사전학습을 네 가지 태스크 세트의 130개 태스크에 걸쳐 평가한다.
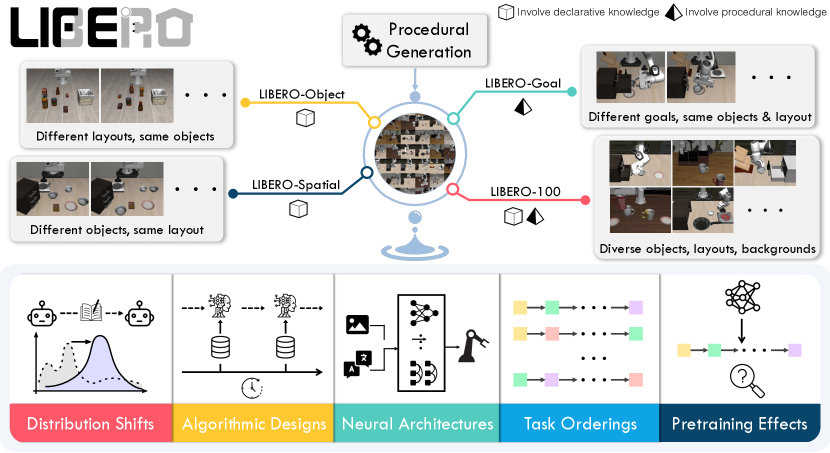
Lifelong learning offers a promising paradigm of building a generalist agent that learns and adapts over its lifespan. Unlike traditional lifelong learning problems in image and text domains, which primarily involve the transfer of declarative knowledge of entities and concepts, lifelong learning in decision-making (LLDM) also necessitates the transfer of procedural knowledge, such as actions and behaviors. To advance research in LLDM, we introduce LIBERO, a novel benchmark of lifelong learning for robot manipulation. Specifically, LIBERO highlights five key research topics in LLDM: 1) how to efficiently transfer declarative knowledge, procedural knowledge, or the mixture of both; 2) how to design effective policy architectures and 3) effective algorithms for LLDM; 4) the robustness of a lifelong learner with respect to task ordering; and 5) the effect of model pretraining for LLDM. We develop an extendible procedural generation pipeline that can in principle generate infinitely many tasks. For benchmarking purpose, we create four task suites (130 tasks in total) that we use to investigate the above-mentioned research topics. To support sample-efficient learning, we provide high-quality human-teleoperated demonstration data for all tasks. Our extensive experiments present several insightful or even unexpected discoveries: sequential finetuning outperforms existing lifelong learning methods in forward transfer, no single visual encoder architecture excels at all types of knowledge transfer, and naive supervised pretraining can hinder agents' performance in the subsequent LLDM. Check the website at https://libero-project.github.io for the code and the datasets.
연구 동기 및 목표
- 결정적 지식과 절차적 지식이 모두 이전되어야 하는 의사결정에서의 평생 학습 연구를 자극한다.
- 다양하고 언어 조건이 있는 로봇 조작 태스크를 생성하는 확장 가능한 태스크 생성 파이프라인을 제공한다.
- 정책 아키텍처, 평생 학습 알고리즘, 사전학습의 전진 및 후진 이전 효과를 체계적으로 평가한다.
- 태스크 순서에 대한 강건성과 LLDM 성능에서 언어 임베딩의 역할을 분석한다.
제안 방법
- Ego4D 언어 주석에서 행동 템플릿을 추출하고 이를 PDDL로 인코딩하여 끝없는 로봇 조작 태스크를 절차적으로 생성한다.
- 비디오 기반 언어 조건 태스크 지시문을 장면 배치 및 초기 물체 구성을 대입한다.
- 네 가지 태스크 세트(LIBERO-Spatial, LIBERO-Object, LIBERO-Goal, LIBERO-100)와 130개 총 태스크를 여러 정책 및 LL 알고리즘에서 평가한다.
- 시연으로 수집된 원격 조작 시연에서 정책을 학습하기 위해 행동 복제(behavioral cloning)를 사용하여 샘플 효율적인 벤치마킹을 가능하게 한다.
- 새로운 태스크를 학습하는 동안 이전 태스크에 대한 접근을 제외하여 lifelong learning 제약을 시뮬레이션한다.
실험 결과
연구 질문
- RQ1다양한 분포 변화 하에서 서로 다른 신경망 아키텍처와 평생 학습 알고리즘이 어떻게 작동하는가?
- RQ2특히 공간, 객체, 목표 지식에 대한 지식 이전에서 아키텍처 선택이 LLDM에 미치는 영향은 무엇인가?
- RQ3감독 학습 문헌의 기존 평생 학습 방법이 로봇 공학의 LLDM에 효과적으로 일반화되는가?
- RQ4언어 임베딩의 품질이나 태스크 식별자 인코딩이 LLDM 성능에 영향을 미치는가?
- RQ5다른 태스크 순서 및 LLDM에서 사전학습에 대한 LLDM 방법의 강건성은 얼마나 되는가?
주요 결과
- Sequential finetuning (SeqL)은 태스크 세트 전반에서 최상의 전진 이전을 달성하며, 종종 전진 이전에서 전용 LL 알고리즘을 능가한다.
- ER(재연)은 태스크 세트에 걸쳐 강건하며 일반적으로 이전에 학습한 태스크의 성능을 유지하여 다른 방법들보다 여러 설정에서 우수한 성과를 보인다.
- PackNet(동적 아키텍처)은 LIBERO-X(객체/공간 다양성)에서 뛰어나지만, 용량의 제한으로 LIBERO-Long에서 저조한 성과를 보인다.
- ViT 기반 아키텍처(ViT-T)와 트랜스포머-인-템포럴 처리 방식은 대부분의 태스크에서 ResNet-RNN보다 우수한 경향이 있으며, LL 알고리즘에 따라 아키텍처 효과가 다르게 나타난다.
- 언어 임베딩(BERT, CLIP, GPT-2, Task-ID)은 LIBERO-Long에서 통계적으로 유의미한 차이를 보이지 않아 현재 임베딩이 태스크 식별자에 대한 단어의 모음처럼 작동함을 시사한다.
- 기본 감독 학습 사전학습은 다운스트림 LLDM 성능을 해칠 수 있으며, 더 신중한 사전학습 전략이 필요함을 시사한다.

이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.