
[논문 리뷰] MoE-Infinity: Efficient MoE Inference on Personal Machines with Sparsity-Aware Expert Cache
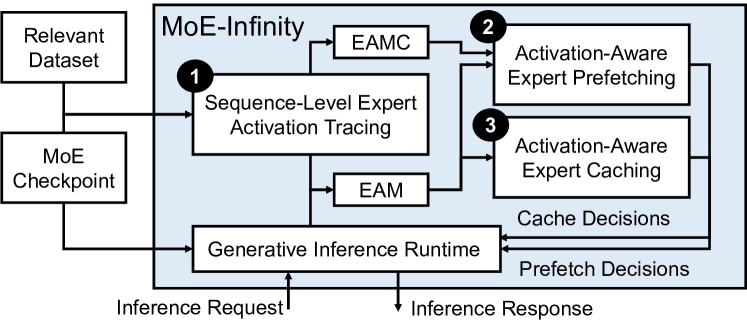
MoE-Infinity은 시퀀스 수준의 전문가 활성화 추적을 활용하여 혼합 전문가(MoE) 서비스에 대한 활성화 인식형 전문가 오프로딩을 도입하고, 표적 프리패칭 및 캐싱을 가능하게 하며, 대기 시간과 배포 비용을 줄입니다.
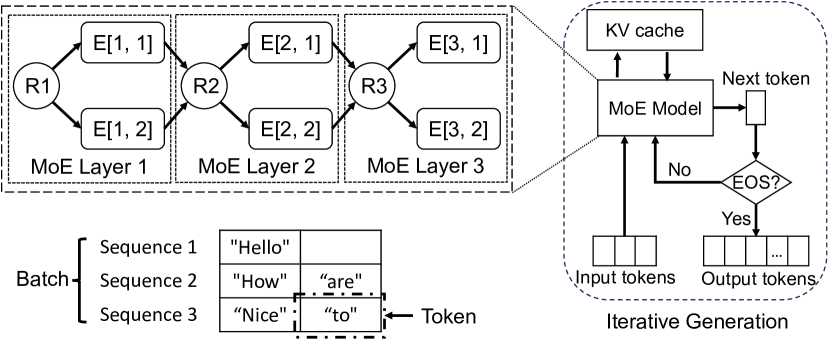
This paper presents MoE-Infinity, an efficient MoE inference system designed for personal machines with limited GPU memory capacity. The key idea for MoE-Infinity is that on personal machines, which are often single-user environments, MoE-based LLMs typically operate with a batch size of one. In this setting, MoE models exhibit a high degree of activation sparsity, meaning a small number of experts are frequently reused in generating tokens during the decode phase. Leveraging this idea, we design a sparsity-aware expert cache, which can trace the sparse activation of experts during inference and carefully select the trace that represents the sparsity pattern. By analyzing these selected traces, MoE-Infinity guides the replacement and prefetching of the expert cache, providing 3.1-16.7x per-token latency improvements over numerous state-of-the-art systems, including vLLM, Ollama, DeepSpeed and BrainStorm across various MoE models (DeepSeek and Mixtral) when handling different LLM tasks. MoE-Infinity's source code is publicly available at https://github.com/EfficientMoE/MoE-Infinity
연구 동기 및 목표
- 비용이 제한된 환경에서 대형 MoE 모델의 서비스에 대한 메모리 및 대기 시간 비용을 줄이는 동기를 제시한다.
- MoE 추론에서 희소 활성화와 시간적 지역성을 활용하기 위한 활성화 인식형 오프로딩을 제안한다.
- 전문가 재사용 패턴을 식별하고 활용하기 위한 시퀀스 수준의 전문가 활성화 추적을 설계한다.
- 오프로딩 오버헤드를 최소화하기 위한 활성화 인식형 프리패칭 및 캐싱을 개발한다.
- 실제 MoE 모델 및 서비스 워크로드에 대해 시스템을 평가하여 대기 시간 및 비용 이점을 입증한다
제안 방법
- Expert Activation Matrices(EAMs)를 활용한 시퀀스 수준의 전문가 활성화 추적을 도입하여 시퀀스별 활성화 패턴을 포착한다.
- 다양한 활성화 패턴을 클러스터링 기반 접근으로 표현하기 위해 Expert Activation Matrix Collection(EAMC)을 구축한다.
- 다음에 활성화될 가능성이 높고 현재 실행 계층 근처의 전문가를 우선시하는 활성화 인식형 전문가 프리패칭을 개발한다.
- 자주 활성화되는 전문가를 우선하는 캐시 교체 정책과 다계층 GPU/호스트 메모리 캐시를 갖춘 활성화 인식형 전문가 캐싱을 구현한다.
- 다중 GPU 서버 및 전문가 병렬 배치를 위한 다계층 프리패칭 및 NUMA-인식 최적화를 통합한다.
- 실제 MoE 체크포인트(Switch Transformers, NLLB-MoE)를 Azure Trace 유사 워크로드로 평가하여 대기 시간 및 비용 개선을 측정한다
실험 결과
연구 질문
- RQ1시퀀스 수준 활성화 추적이 MoE 서빙의 오프로딩 결정에 어떻게 개선될 수 있는가?
- RQ2활성화 인식형 프리패칭 및 캐싱이 기준선과 비교하여 대기 시간 및 배포 비용을 줄일 수 있는가?
- RQ3온라인 서비스에서 분포 변화에 Expert Activation Matrix Collection이 얼마나 잘 적응하는가?
- RQ4다중 GPU 및 다중 서버 배치에서 성능을 극대화하는 하드웨어 및 구현 최적화는 무엇인가?
주요 결과
- MoE-Infinity는 최첨단 기준선 대비 레이턴시를 4–20배 감소시키고 배포 비용도 8배 이상 절감한다.
- 활성화 인식형 프리패칭 및 캐싱은 MoE 오프로딩에서 전통적 프리패칭/캐싱보다 현저히 우수하게 성능을 보인다.
- EAMs를 이용한 시퀀스 수준 추적은 희소 활성화와 시간적 지역성을 포착하여 시퀀스별 패턴이 효과적인 리소스 배치를 가능하게 한다.
- 이 접근법은 다중 GPU 클러스터로 확장되며 사용 불가능한 전문가에 대해 SSD 오프로딩을 포함한 전문가 병렬 서빙을 지원한다.
- 마이크로 벤치마크에서 DeepSpeed 및 BrainStorm 프리패칭 대비 개선과 SOTA MoE 시스템에서 사용된 캐싱 전략 대비 개선을 보인다
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.