
[논문 리뷰] One-for-All: Generalized LoRA for Parameter-Efficient Fine-tuning
GLoRA는 LoRA를 확장한 일반화된 매개변수 효율적 미세조정 프레임워크로, unified layer-wise adapter/prompts 및 재매개화로 비-추론 비용 증가 없이 시각 및 언어 작업에서 더 높은 정확도를 달성합니다.
We present Generalized LoRA (GLoRA), an advanced approach for universal parameter-efficient fine-tuning tasks. Enhancing Low-Rank Adaptation (LoRA), GLoRA employs a generalized prompt module to optimize pre-trained model weights and adjust intermediate activations, providing more flexibility and capability across diverse tasks and datasets. Moreover, GLoRA facilitates efficient parameter adaptation by employing a scalable, modular, layer-wise structure search that learns individual adapter of each layer. Originating from a unified mathematical formulation, GLoRA exhibits strong transfer learning, few-shot learning and domain generalization abilities, as it adapts to new tasks through not only weights but also additional dimensions like activations. Comprehensive experiments demonstrate that GLoRA outperforms all previous methods in natural, specialized, and structured vision benchmarks, achieving superior accuracy with fewer parameters and computations. The proposed method on LLaMA-1 and LLaMA-2 also show considerable enhancements compared to the original LoRA in the language domain. Furthermore, our structural re-parameterization design ensures that GLoRA incurs no extra inference cost, rendering it a practical solution for resource-limited applications. Code and models are available at: https://github.com/Arnav0400/ViT-Slim/tree/master/GLoRA.
연구 동기 및 목표
- 다양한 다운스트림 데이터셋 및 모달리티에 대한 매개변수 효율적 미세조정의 동기를 제시합니다.
- LoRA를 확장하여 가중치 공간을 넘어 가중치와 특징을 조정하는 통합적이고 유연한 프레임워크를 개발합니다.
- 구조적 재매개화를 통해 비용 효율적 추론 및 계층별 진화적 탐색으로 가능하게 합니다.
- 시각 벤치마크(VTAB-1K, ImageNet 변형)와 언어 모델(LLaMA-1/2)에서의 강점 demonstrate합니다.
- 적은 샷 학습, 도메인 일반화 및 기존 PEFT 방법에 비해 견고성 향상을 보여줍니다.
제안 방법
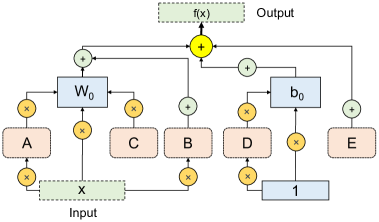
- 가중치 및 특징 공간 적응을 포괄하기 위해 f(x) = (W0 + W0 A + B) x + (C W0 + D b0 + E + b0)를统一 공식으로 제시합니다.
- 가변 형태(LoRA, 벡터, 스칼라, 없음)와 가능한 서브넷에 대한 다경로 슈퍼넷으로 학습 가능한 지원 텐서 A, B, C, D, E를 도입합니다.
- 슈퍼넷 내 계층별 구성을 데이터 기반의 비용 효율적 방법으로 선택하기 위한 진화적 탐색을 활용합니다.
- 추론 시 추가 파라미터가 근접한 투영 가중치에 융합되어 FLOPs나 파라미터 증가 없이 유지되도록 구조적 재매개화를 적용합니다.
- 큰 백본(ViT-B, LLaMA-1/2)에 대해 단일 슈퍼넷을 학습하고 진화를 통한 검증 후 작업별 서브넷을 추출합니다.
- 지원 텐서를 0으로 만들면 이전 방법으로 축소될 수 있는 능력 있는 가중치 및 활성 공간 프레임워크를 시연합니다.
실험 결과
연구 질문
- RQ1통합된 One-for-All 공식이 기존의 PEFT 방법들을 포섭하고 가중치, 특징, 프롬프트 간의 유연한 조정을 제공할 수 있나요?
- RQ2레이어별, 검색 주도형 어댑터 구성과 재매개화를 가능하게 하면 추론 비용 증가 없이 전이학습, 소수 샘플 학습, 도메인 일반화 성능이 향상되나요?
- RQ3다양한 데이터셋에서 비전 및 자연어 백본에 대해 GLoRA의 성능은 최첨단 PEFT 방법들과 비교하여 어떤가요?
- RQ4레이어별 구성에 대한 진화적 탐색이 정확도와 학습 시간에 어떤 영향을 미치나요?
- RQ5GLoRA는 활성화 및 프롬프트로 확장된 조정 용량을 유지하면서 추론 효율성을 유지하나요?
주요 결과
- GLoRA는 VTAB-1K, ImageNet 변형 및 언어 벤치마크에서 기존 PEFT 방법보다 더 높은 평균 정확도와 더 적은 학습 가능한 파라미터를 달성합니다.
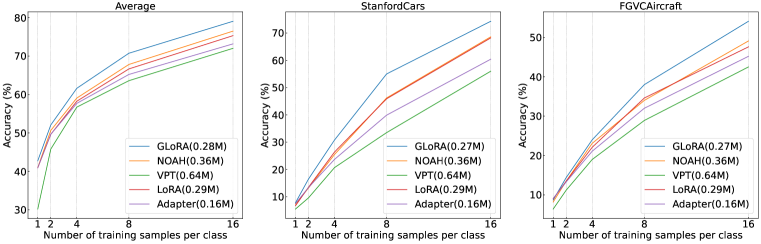
- GLoRA는 ImageNet 변형 및 Open LLM Leaderboard 과제를 포함한 여러 데이터셋에서 뛰어난 소수 샷 학습 및 도메인 일반화를 달성합니다.
- 구조적 재매개화로 인한 추가 추론 비용이 제로로 유지되어 다른 많은 PEFT 방법들과 차별화됩니다.
- 일부 지원 텐서를 0으로 만들면 GLoRA는 이전 방법들의 상위 집합으로 동작하여 이전 PEFT 기법들의 보완으로 작용할 수 있습니다.
- ViT-B 및 LLaMA-1/2에 대한 실험에서 시각 및 언어 작업 전반에 걸쳐 제한된 추가 조정 파라미터로 일관된 이득이 나타납니다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.