
[논문 리뷰] Open-Vocabulary Panoptic Segmentation with Text-to-Image Diffusion Models
ODISE는 고정된 텍스트-이미지 확산 모델 표현과 판별 모델을 활용하여 개방 어휘 파노픽 분할(open-vocabulary panoptic segmentation)을 수행하며, 개방 어휘 파노픽 및 의미 분할 벤치마크에서 최첨단 결과를 달성합니다.
We present ODISE: Open-vocabulary DIffusion-based panoptic SEgmentation, which unifies pre-trained text-image diffusion and discriminative models to perform open-vocabulary panoptic segmentation. Text-to-image diffusion models have the remarkable ability to generate high-quality images with diverse open-vocabulary language descriptions. This demonstrates that their internal representation space is highly correlated with open concepts in the real world. Text-image discriminative models like CLIP, on the other hand, are good at classifying images into open-vocabulary labels. We leverage the frozen internal representations of both these models to perform panoptic segmentation of any category in the wild. Our approach outperforms the previous state of the art by significant margins on both open-vocabulary panoptic and semantic segmentation tasks. In particular, with COCO training only, our method achieves 23.4 PQ and 30.0 mIoU on the ADE20K dataset, with 8.3 PQ and 7.9 mIoU absolute improvement over the previous state of the art. We open-source our code and models at https://github.com/NVlabs/ODISE .
연구 동기 및 목표
- 확산 모델 표현을 활용하여 개방 어휘 인식과 파노픽 분할을 연결한다.
- 사전 학습된 텍스트-이미지 확산 특징을 판별 모델과 통합하여 개방 범주 레이블링을 수행한다.
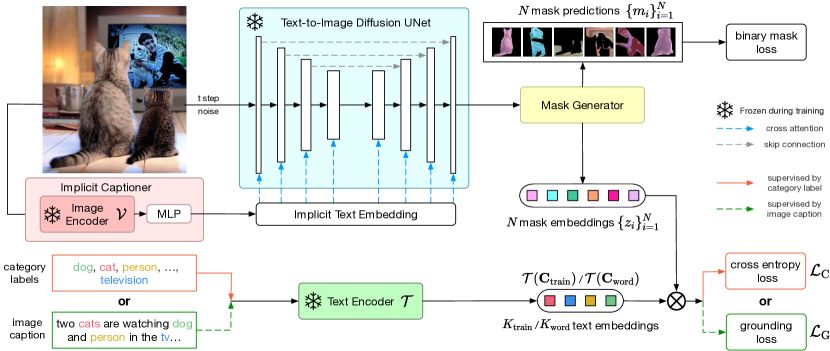
- 카테고리 라벨 또는 이미지 캡션 중 하나를 사용하여 마스크 생성기와 개방 어휘 분류기를 학습한다.
- 개방 어휘 파노픽 및 의미 분할 벤치마크에서 최첨단 성능을 입증한다.
제안 방법
- 암시적 캡션기를 사용하여 이미지 조건 특성 맵을 생성하고, 고정된 텍스트-이미지 확산 UNet에서 확산 모델 특징을 추출한다.
- 확산 특징으로부터 클래스 비특정 이진 마스크와 대응하는 마스크 임베딩을 예측하도록 마스크 생성기를 학습한다.
- 각 마스크를 분류하기 위해 마스크 임베딩과 학습 카테고리 이름의 텍스트 임베딩 또는 이미지 캡션의 명사 간의 유사도를 계산하고, 교차 엔트로피 손실 또는 그라운딩 손실을 사용한다.
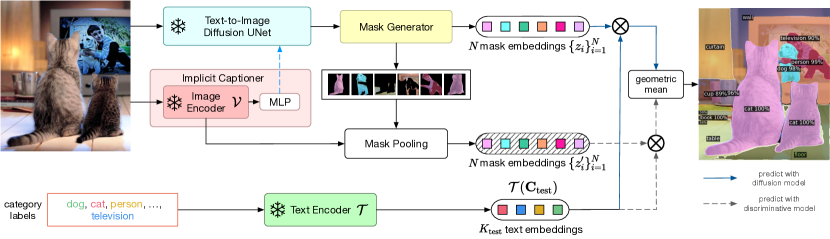
- 추론 시 ODISE로 마스크를 생성하고 확산 모델 예측과 판별 모델(CLIP) 예측을 기하 평균으로 융합하여 최종 개방 어휘 레이블을 얻는다.
실험 결과
연구 질문
- RQ1대규모 텍스트-이미지 확산 모델의 내부 표현을 활용하여 개방 어휘 파노픽 분할을 효과적으로 학습할 수 있는가?
- RQ2확산 기반 특징과 판별적 텍스트-이미지 모델을 결합하면 더 우수한 개방 어휘 분할 성능을 얻을 수 있는가?
- RQ3테스트 시 캡션이 이용 불가능할 때 확산 모델 특성 품질을 극대화하도록 암시적 캡션은 어떻게 구성되어야 하는가?
- RQ4개방 어휘 분할에서 캡션 감독과 캡션 없는 방법 간의 트레이드오프는 무엇인가?
주요 결과
- ODISE는 개방 어휘 파노픽 분할에서 최첨단 성과를 달성하며, 특히 ADE20K에서 23.4 PQ 및 28.7–29.9 mIoU, COCO에서 55.4 PQ / 65.2 mIoU를 다양한 감독 설정에서 달성했다.
- 레이블+마스크 감독을 사용하면 보고된 설정에서 캡션 감독보다 ADE20K PQ(22.6) 및 mIoU(29.9)가 더 높고, COCO 결과는 여전히 강력하다(55.4 PQ, 65.2 mIoU).
- ODISE는 ADE20K에서 개방 어휘 파노픽 분할에 대해 MaskCLIP보다 8.3 PQ 더 우수하다.
- 개방 어휘 의미 분할은 A-150, A-847, PC-459 데이터세트에서 캡션 감독과 라벨 감독 하에서 여러 mIoU 포인트의 상승을 통해 크게 이득을 얻는다.
- 소형 모델(학습 가능한 매개변수 28.1M, 전체 모델의 1.8%)이 1,493.8M의 고정 매개변수로 V100에서 1024^2 이미지에 대해 1.26 FPS를 달성하며, 메모리 11.9 GB를 사용한다.
- 확산 기반 예측과 판별 모델 예측의 융합(기하 평균)은 평가된 데이터셋 전반에서 단독으로 사용할 때보다 더 나은 결과를 낸다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.