
QUICK REVIEW
[논문 리뷰] OpenFlamingo: An Open-Source Framework for Training Large Autoregressive Vision-Language Models
Anas Awadalla, Irena Gao|arXiv (Cornell University)|2023. 08. 02.
한 줄 요약
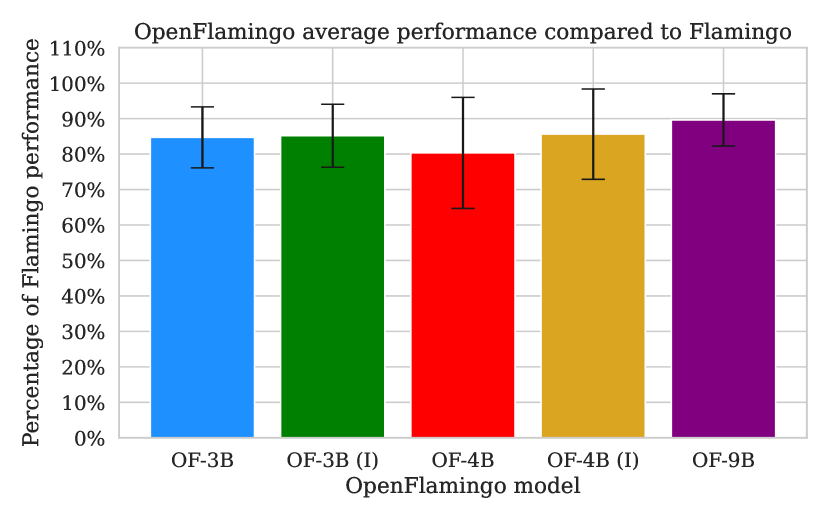
OpenFlamingo는 웹 데이터를 기반으로 학습된 오픈 소스 자동회귀 비전-언어 모델(3B–9B)을 제공하며, 7개 데이터셋에서 컨텍스트 내 시연을 활용했을 때 Flamingo 성능의 약 80–89%를 달성합니다.
ABSTRACT
We introduce OpenFlamingo, a family of autoregressive vision-language models ranging from 3B to 9B parameters. OpenFlamingo is an ongoing effort to produce an open-source replication of DeepMind's Flamingo models. On seven vision-language datasets, OpenFlamingo models average between 80 - 89% of corresponding Flamingo performance. This technical report describes our models, training data, hyperparameters, and evaluation suite. We share our models and code at https://github.com/mlfoundations/open_flamingo.
연구 동기 및 목표
- 프라이빗 가중치나 데이터 없이 연구를 가능하게 하는 오픈 소스 자동회귀 비전-언어 프레임워크의 필요성을 설계합니다.
- 공개 인코더와 디코더를 사용하여 Flamingo 스타일의 교차 주의 비전-언어 아키텍처를 재현합니다.
- 컨텍스트 시연을 포함한 다양한 비전-언어 태스크에서 오픈 모델을 평가하여 일반화 및 적은 샷 학습 능력을 검토합니다.
- 데이터 소스와 학습 선택을 분석하여 폐쇄형 시리즈 모델 대비 성능 차이를 이해합니다.
제안 방법
- 고정된 언어 모델과 고정된 비전 인코더를 교차 주의 모듈로 연결하는 Flamingo 아키텍처를 재현합니다.
- 고정된 비전 인코더(CLIP ViT-L/14)를 통해 이미지 임베딩을 얻고 이미지 임베딩용 Perceiver 리샘플러를 학습합니다.
- 일부 모델은 ChatGPT 생성 시퀀스를 포함하여 LAION-2B(이미지-텍스트 쌍) 및 MMC4와 같은 오픈 웹 스크랩 데이터셋으로 학습합니다.
- <image> 및 <|endofchunk|> 토큰으로 시퀀스를 전처리하고 AdamW 최적화를 사용하여 다음 토큰 예측을 수행합니다.
- 표준 및 명령어-튜닝된 언어 백본을 포함하여 3B, 4B, 9B 파라미터 스케일로 실험합니다.
- 0, 4, 8, 16, 32의 다양한 컨텍스트 예시 수와 일부 설정에서 Retrieval-based In-Context Example Selection(RICES)을 사용하여 7개의 비전-언어 벤치마크를 평가합니다.
실험 결과
연구 질문
- RQ1오픈 소스 자동회귀 비전-언어 모델이 다양한 비전-언어 태스크에서 Flamingo의 성능에 얼마나 근접할 수 있는가?
- RQ2모델 규모(3B, 4B, 9B)와 언어 모델 백본(표준 대 명령어-튜닝)에 따른 제로샷 및 맥락 내 학습 성능에 어떤 영향이 있는가?
- RQ3오픈 학습 데이터(LAION-2B 및 MMC4)와 데이터 처리 선택이 맥락 내 학습 및 VQA 스타일 태스크에 어떤 영향을 미치는가?
- RQ4학습 가능한 임베딩 대 고정 임베딩이 다운스트림 성능에 어떤 역할을 하는가?
- RQ5오픈 소스 모델이 맥락 시연을 활용해 파인 튜닝된 최첨단(SOTA)과 경쟁 가능한 성과를 달성할 수 있는가?
주요 결과
- OpenFlamingo-3B 및 -9B가 7개 데이터셋에서 각각 Flamingo 성능의 평균 85% 및 89%를 달성합니다.
- 0샷 및 4샷 설정에서 OpenFlamingo-9B가 여러 데이터셋에서 Flamingo-9B에 근접하고 COCO, VQAv2, VizWiz에서 4샷 성능과 거의 일치합니다.
- OpenFlamingo-4B 모델은 종종 3B 모델보다 성능이 낮고 이미지를 나타내는 임베딩을 고정하면 성능이 크게 저하될 수 있습니다(예: COCO, VQAv2).
- 언어-명령어 튜닝은 일부 OpenFlamingo 변형에서 향상을 보이며, RedPajama-3B 백본에서 특히 큰 이득이 있습니다.
- OpenFlamingo-9B는 상당한 이득을 보이지만 최첨단 수준까지 이르지는 않으며, 32 RICES 시演에서 파인 튜닝된 SoTA에 비해 평균 약 62%의 성능을 달성합니다.
- 데이터셋에 따라 성능 추세가 다르게 나타나며, VQAv2는 언어 모델 선택에 큰 민감도를 보이는 반면 COCO 기반 CIDEr 점수는 더 많은 맥락 예시와 함께 꾸준히 개선됩니다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.