
[논문 리뷰] RoboCat: A Self-Improving Generalist Agent for Robotic Manipulation
RoboCat은 다중 구현체, 다중 작업 비전 기반 일반 목적 에이전트이며 시각 목표 조건화를 가진 트랜스포머 모델을 사용하여 새로운 로봇 작업과 구현에 적응하기 위해 자기 개선 학습 루프를 사용합니다.
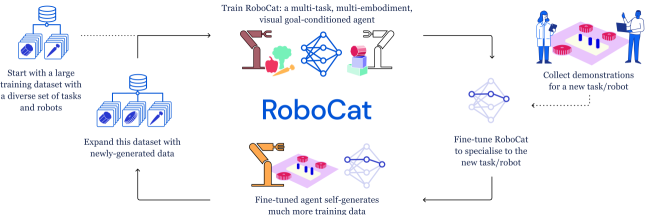
The ability to leverage heterogeneous robotic experience from different robots and tasks to quickly master novel skills and embodiments has the potential to transform robot learning. Inspired by recent advances in foundation models for vision and language, we propose a multi-embodiment, multi-task generalist agent for robotic manipulation. This agent, named RoboCat, is a visual goal-conditioned decision transformer capable of consuming action-labelled visual experience. This data spans a large repertoire of motor control skills from simulated and real robotic arms with varying sets of observations and actions. With RoboCat, we demonstrate the ability to generalise to new tasks and robots, both zero-shot as well as through adaptation using only 100-1000 examples for the target task. We also show how a trained model itself can be used to generate data for subsequent training iterations, thus providing a basic building block for an autonomous improvement loop. We investigate the agent's capabilities, with large-scale evaluations both in simulation and on three different real robot embodiments. We find that as we grow and diversify its training data, RoboCat not only shows signs of cross-task transfer, but also becomes more efficient at adapting to new tasks.
연구 동기 및 목표
- 이종 로봇 경험을 활용하는 일반 목적 로봇 조작 에이전트의 필요성을 동기 부여합니다.
- 다양한 구현체와 작업을 처리할 수 있는 시각 목표 조건화 트랜스포머인 RoboCat을 제안합니다.
- 자기 개선을 위한 자동 데이터 수집과 함께 100–1000 시연으로 새로운 작업에 대한 미세 조정을 시연합니다.
- 교차 작업 전이, 더 크고 다양한 데이터로 인한 효율성 향상, 지속 학습을 위한 자체 데이터 생성을 보여줍니다.
제안 방법
- 모델 아키텍처: 시각 관측을 토큰화하기 위한 고정된 VQ-GAN 이미지 인코더를 가진 대형 자기회귀 트랜스포머(디코더 전용, ~1.18B 파라미터).
- 시각 목표를 통한 작업 명세; 목표는 궤적 내에서 반복되며 재레이블링을 위해 회상 목표를 사용할 수 있습니다.
- 학습 목표는 VQ-GAN 인코더의 이미지 토큰을 활용하기 위해 행동 토큰 예측과 미래 이미지 토큰 예측을 결합합니다.
- 데이터 통합: RoboCat은 다수의 구현체, 작업 및 객체 세트에 걸친 다양 한 데이터 세트에서 작업 변형을 토큰 시퀀스로 인코딩하여 학습합니다.
- 미세 조정 및 자기 개선: 새로운 작업에 대해 100–1000 시연으로 미세 조정하고, 자율적으로 정책에 따른 데이터를 수집하도록 배포하며, 회상 목표로 재레이블링하고 다음 일반 목적 반복을 재학습합니다.
- 현실 세계 배포: 작업 전역에서 확장 가능한 데이터 수집을 가능하게 하는 성공 탐지 보상 모델과 정책 풀을 통한 자율 재설정.
실험 결과
연구 질문
- RQ1RoboCat은 이종 다중 구현 데이터로부터 학습하여 다양한 정교한 조작 작업 세트를 해결할 수 있을까요?
- RQ2적은 수의 시연으로 보지 못한 작업, 객체, 구현에 얼마나 잘 적응할 수 있을까요?
- RQ3RoboCat은 교차 작업 전이를 보여주고 더 넓고 다양한 학습 데이터로 향상될까요?
- RQ4RoboCat은 자율적으로 데이터를 수집하고 이를 후속 학습 반복에 통합하여 자기 개선할 수 있을까요?
주요 결과
- 단일 RoboCat 에이전트가 여러 구현체 및 객체 세트에 걸쳐 253개의 학습 및 미세 조정 작업 변형을 수행할 수 있습니다.
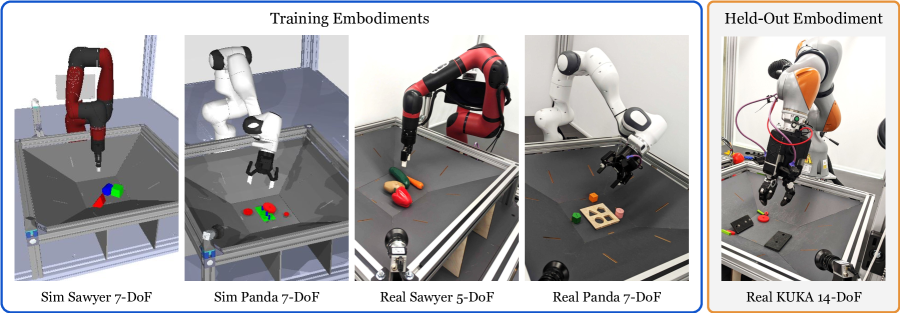
- RoboCat은 보이지 않는 작업에 대해 100–1000 시연으로 미세 조정하며, 초기 학습에서 보지 못한 14-DoF KUKA 구현에 적응할 수 있습니다.
- 자율 데이터 수집과 재레이레이블링을 통한 자기 개선은 일반 목적 능력과 미세 조정 효율성의 반복적 향상을 가져옵니다.
- 비전 기반 모델 기초를 로봇 이외의 데이터로 학습한 기준선과 비교했을 때, RoboCat은 학습 작업에서 더 높은 성능과 미세 조정 작업에서 우수한 적응성을 달성합니다.
- 다양한 로봇 데이터의 규모 확장은 학습 작업의 성능을 향상시키고 새로운 작업에 대한 적응 속도를 높입니다.
이 논문 읽기
누빈트 뷰어에서 원문을 열고, 읽으면서 궁금한 곳을 바로 물어보세요.
누빈트에서 이 논문 읽기이 리뷰는 AI가 논문 원문을 바탕으로 만들었습니다. 인용하기 전에 원문을 확인해 주세요.